Поздно вечером попросили помочь с отчётом по обходу большого многоэтажного здания. На руках несколько сотен файлов, десятки гигабайт: человек ходит по этажам, снимает стены, швы, стёкла, панели и вслух проговаривает, что не так. Иногда показывает табличку с номером помещения. Иногда не показывает. К утру из этого нужна дефектовка.
Один ролик уже попробовали разобрать через ChatGPT. Получилось. Осталось несколько сотен.
Обстоятельства обращения и детали объекта здесь опущены, объёмы округлены. Для рассказа важен масштаб работы: много этажей, около двух часов видео и сотни замечаний, которые нужно разнести по помещениям и видам работ.
Куда лить десятки гигабайт в полночь
Первый вопрос был не про распознавание. Первый вопрос был, как весь этот объём переедет на мой ноутбук.
Для передачи я использовал свой файлообменник на базе Pingvin Share. Ссылка, пароль, срок жизни, размер файла ограничен только диском. Мог бы и с нуля навайбкодить, но зачем, когда лежит готовое.
По небольшой партии роликов я собрал тестовый прогон: расшифровка, кадры, PDF с дефектами по помещениям. Ролики переименовал по содержанию, чтобы по имени было видно, где и что снято. Стало понятно, что задача решаемая и что вопрос упирается в бюджет токенов, а не в принцип.
Загрузка остальных материалов шла медленно. Пока ждал, получил рабочие XLSX-шаблоны заказчика: матрица «помещения × виды работ», формулы и места под фотографии. Попросили в их формате.
Тестовый PDF отложил. Переименование роликов отменил: в таблице должны стоять исходные имена, по которым заказчик найдёт запись у себя. Первое правило проекта после этого звучало так: те же самые шаблоны, заполненные данными, с сохранением структуры листов, оформления и формул. Оригиналы не трогать, работать с копиями. Исходные имена файлов канонические. Отсутствующие объёмы и цены не выдумывать.
Демка и прод
На тестовом файле файлообменник работал красиво. Ночью пошёл прод.
Первая партия, несколько десятков файлов, приехала штатно. Следующая, больше сотни, легла за одним роликом: он ушёл в бесконечный повтор загрузки, шара так и не отметилась завершённой, а незавершённая шара в интерфейсе не показывает ни одного файла. На странице пусто, на диске сервера файлы лежат под внутренними идентификаторами, а человеческие имена лежат в SQLite.
Пришлось написать скрипт восстановления имён. Он читал копию базы, сопоставлял идентификаторы с исходными именами, проверял, что в имени нет .. и абсолютных путей, и атомарно записывал карту соответствия. После этого инвентаризация увидела загруженные файлы. Зависший ролик дозагрузили отдельно.
После сдачи я сел чинить файлообменник: бюджет повторов три попытки на файл, ошибки 4xx не повторяются вовсе, статус загрузки paused/failed вместо вечного колеса, список незавершённых загрузок в админке и регрессионные тесты. На одиночном тестовом файле эти проблемы не проявились. На сотне файлов посреди ночи проявились все разом.
Конвейер
Исходные материалы (несколько сотен файлов)
  ↓ инвентаризация + SHA-256 + поиск дублей
  ↓ ffmpeg: моно 16 кГц из каждой дорожки
  ↓ Whisper large-v3-turbo локально (Metal), русский
  ↓ второй проход по неразборчивым фрагментам
  ↓ ffmpeg: кадры на фиксированных долях длительности
  ↓ ручная вычитка → проверенный реестр замечаний (JSON)
  ↓ заполнение XLSX-шаблонов + вставка кадров
  ↓ проверка выгрузки как данных
Готовые XLSX-книги с кадрами (десятки мегабайт)
Основной объём составляли видео, к ним добавлялись фотографии и аудиозаписи. После удаления дублей осталось около двух часов видео. На выходе несколько сотен замечаний с идентификаторами и кадрами, сотни заполненных ячеек матрицы и отдельный список материалов, которые не вошли в реестр.
Часть замечаний нельзя было уверенно привязать к этажу или помещению. Где-то не было доступа, где-то номер в речи расходился с табличкой в кадре. Такие места пришлось разбирать отдельно: иначе аккуратно заполненная таблица отправила бы человека искать дефект не туда.
Решения, которые оказались важнее модели
Кэш по содержимому, а не по имени
Ключ кэша SHA-256 файла. Не имя, не путь, не дата.
Материалы приходили партиями, с переименованиями и повторной отправкой того, что уже было. Один и тот же ролик мог оказаться в разных папках под разными именами, и распознавать его дважды незачем. При этом все имена сохраняются как псевдонимы: в отчёте ссылка идёт на то имя, которое заказчик видит у себя.
Побочный эффект приятный: дубли не раздувают количество замечаний. Повторные отправки отсеялись без ручной сверки сотен файлов.
Возобновляемость важнее скорости
Обработка нескольких сотен записей на локальной модели может занять часы. За это время может случиться что угодно: закончится память, уснёт ноутбук, приедет вторая партия файлов.
Поэтому каждый этап пишет контрольную точку атомарно: временный файл, fsync, replace. Статус этапа лежит рядом с кэшем. Повторный запуск не начинает заново, а продолжает: уже есть звуковая дорожка, пропускаем её извлечение; есть расшифровка, пропускаем распознавание. Так первая партия была собрана в отдельные книги ещё до загрузки остальных материалов. Когда они приехали, конвейер продолжил с того места, где остановился.
Журнал в формате JSONL, одна строка на событие. По нему восстанавливается ход работы: какую партию увидела инвентаризация, что обработалось, где произошёл сбой.
Правила проекта тоже появились не сразу. Скрипт курирования один раз затёр ручную правку реестра, после чего сырые расшифровки, проверенный реестр и редакционные формулировки стали жить в разных файлах, а в инструкциях для агента появилось, что канонично и что нельзя перезаписывать.
Второй проход по неразборчивому
Обход снимали на телефон: гулкие холлы, эхо, шум вентиляции, речь в сторону от микрофона. Turbo-модель на таких кусках даёт кашу.
Решение не менять модель целиком, а сделать второй проход точечно. Я отмечаю фрагменты, где расшифровка выглядит подозрительно, и по ним запускается large-v3 (не turbo) на вырезанном кусочке, предварительно прогнанном через highpass=f=100, lowpass=f=7000, loudnorm. Полоса под голос, нормализация громкости, и номер кабинета внезапно слышен.
Это дорого по времени на минуту записи, но применяется к минутам, а не к часам.
ASR галлюцинирует, и это надо вычищать руками
На коротких роликах без речи Whisper выдавал «Продолжение следует...» и подписи к субтитрам. В аудио этих слов не было.
В отчёте такая строка это выдуманный дефект. Поэтому короткие ролики с такими расшифровками после проверки попали в список исключённых с пояснением причины.
Вывод общий для любой работы с моделью: выход ASR это сырьё, а не факт. Сырые расшифровки лежат отдельно от отредактированных формулировок отчёта, и в XLSX попадает только то, что прошло вычитку.
Не выдумывать это техническое требование, а не вежливость
Самое ценное в этом отчёте то, чего в нём нет.
- Пустая ячейка означает «данных нет», а не «дефектов нет».
- Если по речи и кадру нельзя определить этаж, пишется «уточнить». Соседний номер файла не считается доказательством этажа, хотя соблазн большой: файлы-то идут подряд.
- Количество указано только там, где человек вслух назвал конкретные элементы («три крепления слева»). Площади и длины не восстанавливаются «на глаз» по видео.
- Часть файлов вынесена в отдельную таблицу исключений с причиной по каждому: «короткая обзорная запись, отдельный дефект не установлен», «доступ в кабинет отсутствовал», «показано открывание двери, неисправность не названа».
В отчёте есть строчка, которую я считаю главной: количество замечаний это не физический объём ремонта. Сотни записей не превращаются в смету автоматически, потому что повторные съёмки одного участка нужно сверить на объекте.
Соблазн был обратный: дорисовать площади и выдать документ, который выглядит завершённым. Такой документ разваливается на первом же сметном расчёте, и вместе с ним разваливается доверие.
Доказательство на каждую строку
Каждое замечание тянет за собой: исходное имя файла, SHA-256, таймкод речевого фрагмента, кадр из видео на этом таймкоде.
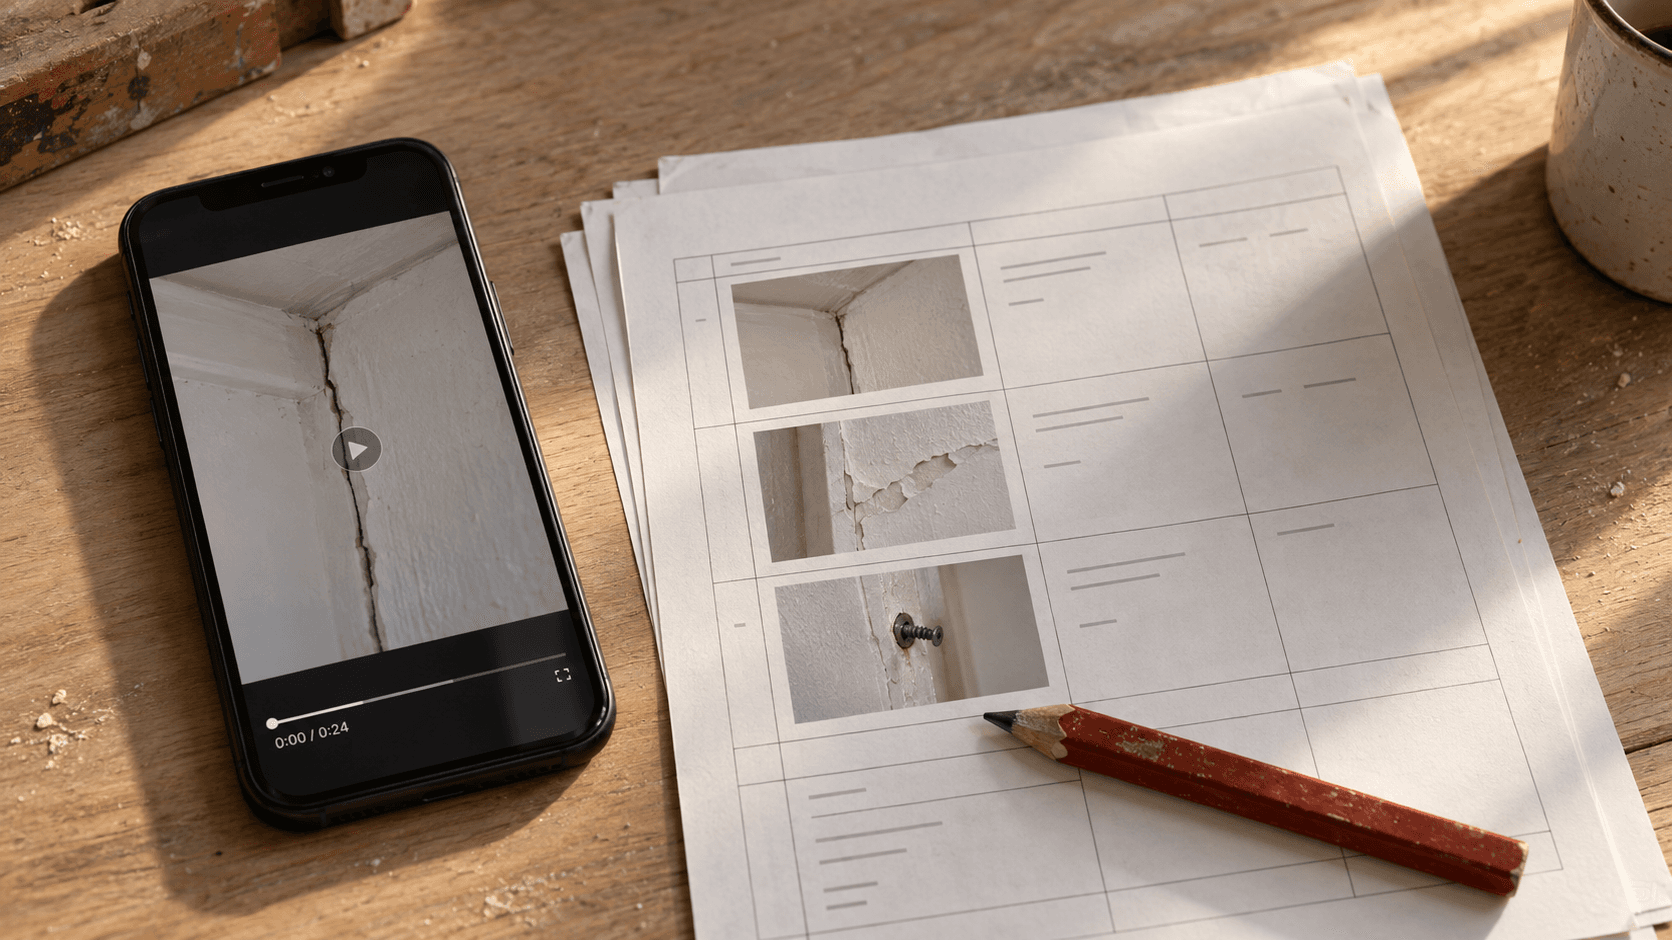
Кадры режутся на фиксированных долях длительности (четверть, половина, три четверти, 92%) плюс пара ранних: этого достаточно, чтобы для любого фрагмента нашлась картинка с нужным участком. В XLSX кадр вставляется прямо в ячейку матрицы: заказчик видит фотографию повреждения рядом с его описанием и привязкой к помещению.
Это превращает расшифровку в документ, с которым можно спорить. Спорный пункт открывается по таймкоду в исходном файле за пять секунд.
Выгрузку надо проверять как данные
Готовый XLSX это zip с XML внутри. Значит, проверять его можно программой, а не глазами.
Скрипт валидации распаковывает книгу и проверяет: нет ли ячеек с ошибками (#REF!, #DIV/0!, #VALUE!), не перекрываются ли диапазоны ширин колонок, на месте ли картинки. Сравнивает SHA-256 вставленных изображений с исходными кадрами и проверяет их координаты и размеры в EMU. Плюс рендер диапазонов в PNG, чтобы посмотреть на результат целиком.
Нашлось этим, например, наложение диапазонов колонок после программной вставки: то, что в предпросмотре выглядит нормально, а в Excel съезжает.
Что это стоило по времени
От обращения до готовых книг прошла ночь. Сначала тестовый прогон, затем адаптация под шаблоны, обработка первой партии, восстановление имён после сбоя загрузки и сборка общего отчёта. Заказчик получил файлы до утреннего срока.
Само распознавание заняло около часа. Остальное: файлообменник, инвентаризация, вычитка, привязка каждого замечания к помещению и категории, сборка книг и проверка выгрузки. Модель сделала самую заметную часть работы и далеко не самую большую.
Где это применимо ещё
Схема повторяется почти дословно для любой работы, где люди наговаривают и наснимают, а нужен документ:
- приёмка квартир и объектов;
- инвентаризация оборудования по видеообходу;
- протоколы совещаний, где важны решения со ссылкой на минуту записи;
- разбор звонков поддержки в реестр проблем.
Общее у них одно: ценность не в расшифровке, а в структуре. Реестр с идентификаторами, привязкой к источнику и честными пробелами. Расшифровку сегодня делает кто угодно, включая сам телефон и ChatGPT на отдельном ролике. Документ, который выдерживает проверку сметчиком, пока нет.